ProjetsProjet phare
NYC Taxi dbt Analytics
Modélisation dimensionnelle avec dbt et DuckDB : 109 047 518 courses yellow en source, 8 298 395 faits échantillonnés et 34 tests exécutés en CI.
Vue d'ensemble
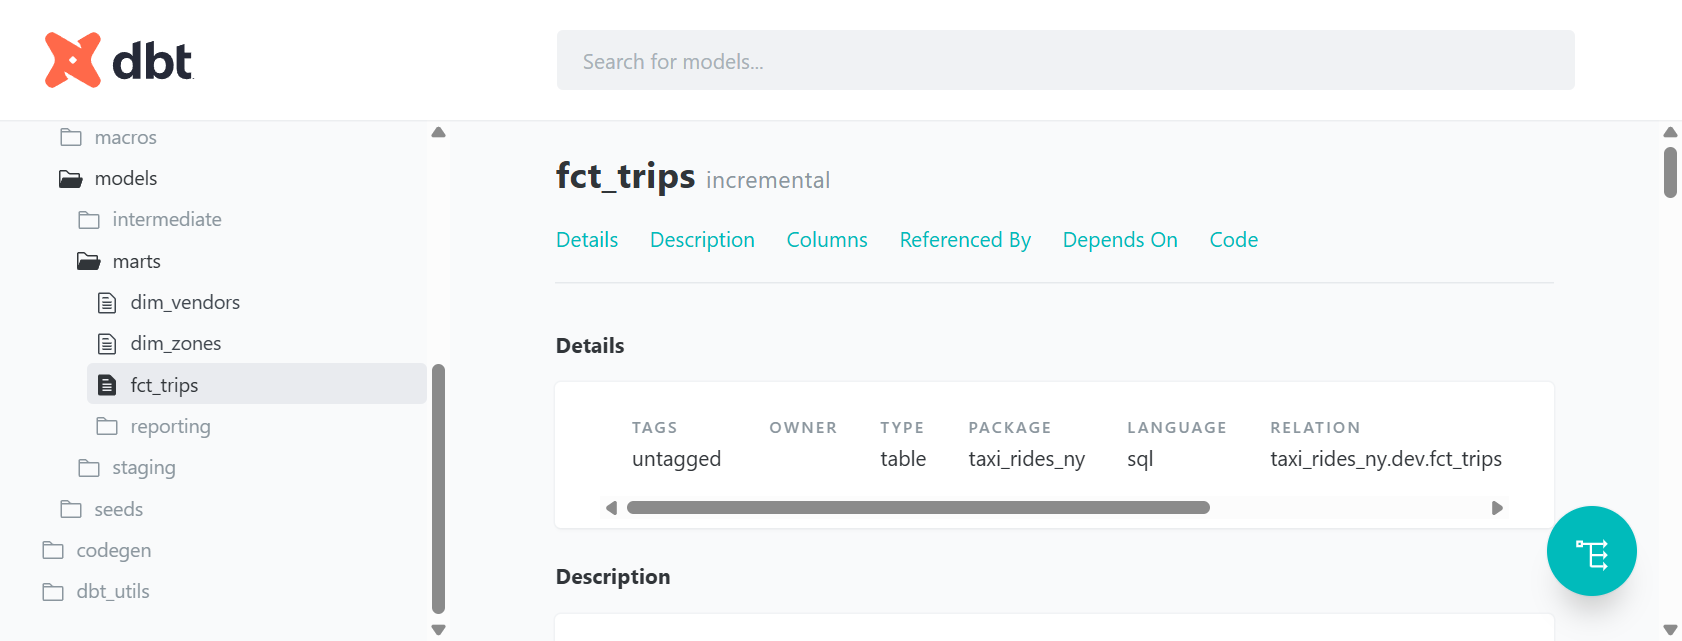
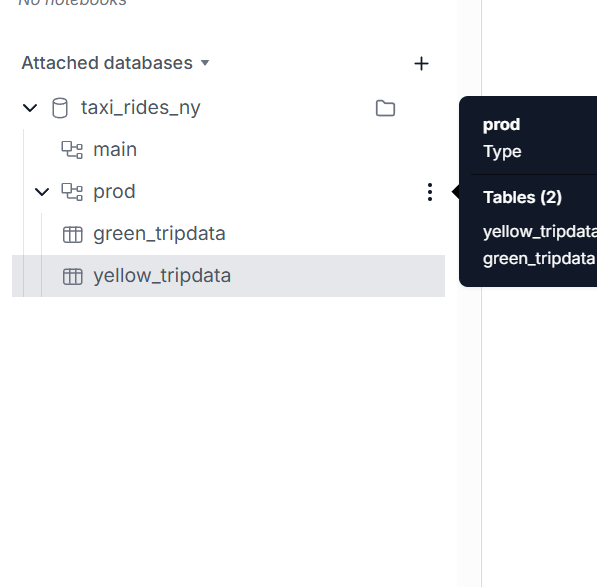
Entrepôt d'analytics engineering pour les taxis yellow et green. ingest_data.py pose les fichiers mensuels en Parquet dans DuckDB (schéma prod). dbt enchaîne staging, intermediate et marts — dimensions zones et vendors, fct_trips incrémental, revenu mensuel par zone. Seeds, macros, dbt_utils et docs générées. Module 04 du Zoomcamp, exécuté en local plutôt que sur BigQuery.
Interface
Problème
La TLC publie des dizaines de millions de lignes, avec des colonnes yellow/green incompatibles. Il faut des modèles typés, documentés, joignables — pas un tas de CSV.
Solution technique
Chargement Parquet dans DuckDB, puis construction staging → intermediate → marts avec dbt. La couche intermédiaire calcule désormais trip_id à partir du grain stable complet : une ancienne clé trop courte supprimait 202 906 courses valides. Le modèle corrigé conserve les 8 298 395 lignes de janvier et une fixture CI protège cette régression.
Ce que contient le dépôt
- ingest_data.py : CSV.gz → Parquet → schéma DuckDB prod
- Staging yellow et green avec nommage commun
- Schéma en étoile : dim_zones, dim_vendors, fct_trips incrémental, fct_monthly_zone_revenue
- Seeds zones et types de paiement ; macros safe_cast et durée de course
- Packages dbt_utils et codegen ; docs dbt générées et servies en local
Choix techniques
- DuckDB plutôt que BigQuery en local
- Le module Zoomcamp vise BigQuery. Ici les mêmes idées de modélisation tiennent dans un fichier DuckDB, sans facture cloud.
- Faits incrémentaux
- fct_trips fusionne sur trip_id pour ajouter des mois sans reconstruire 8 millions de lignes.